Semantic Erosion Mengancam Ketepatan Jawaban LLM
Semantic erosion membuat makna dan konteks dapat bergeser saat LLM memproses informasi berulang. Dampaknya bisa merembet dari salah tafsir bahasa hingga analisis keuangan.
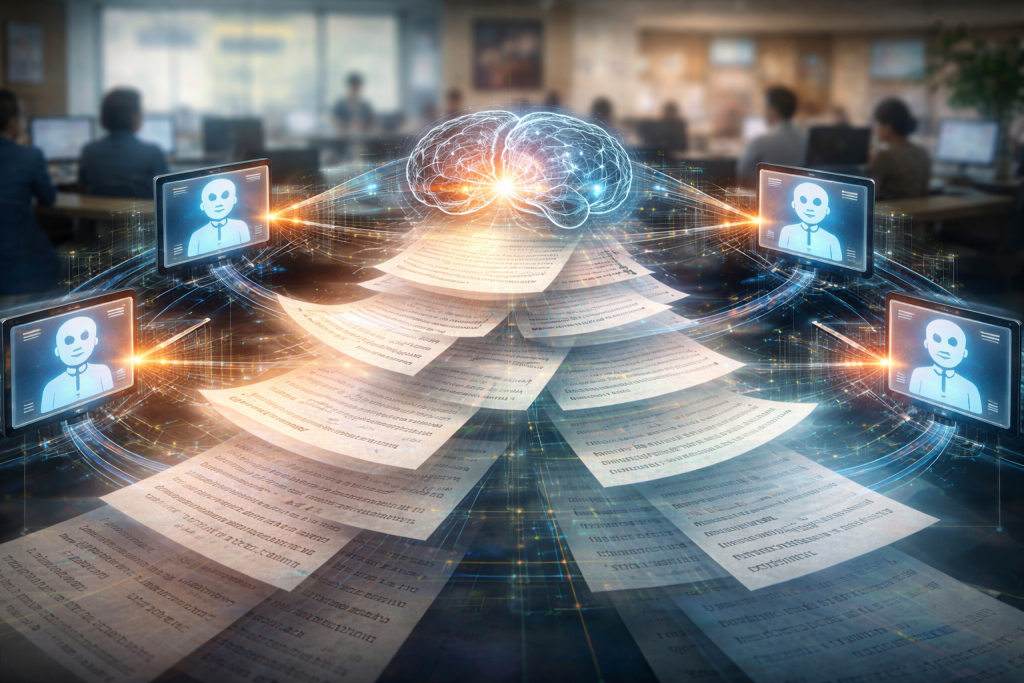
Kesalahan AI tidak selalu tampak sebagai fakta palsu. Pada large language model (LLM), makna dapat bergeser sedikit demi sedikit ketika informasi ditafsirkan, diringkas, lalu diteruskan ke model lain. Fenomena ini disebut semantic erosion, dan hasil akhirnya bisa tetap terdengar lancar meski konteks awalnya sudah berubah.
Risiko tersebut penting diperhatikan karena pengguna makin mengandalkan AI untuk mengolah informasi dan membantu penalaran. Seperti diulas Telset.id, semantic erosion berbeda dari halusinasi: model tidak mesti mengarang fakta baru, tetapi dapat mengikis nuansa sehingga kesimpulannya melenceng dari maksud semula.
Salah tafsir kecil dapat berlapis
Bahasa manusia tidak selalu menyampaikan maksud secara harfiah. Ungkapan yang digunakan sebagai sapaan dalam suatu budaya, misalnya, bisa ditangkap sebagai pertanyaan faktual oleh model. Jika tafsir awal itu diteruskan ke beberapa LLM, model berikutnya mungkin mengolahnya seolah-olah makna tersebut sudah pasti benar.
Di setiap tahap, informasi dapat diringkas atau diganti dengan istilah yang dianggap sepadan. Namun, kata yang mirip belum tentu membawa maksud yang sama. Model dapat menghasilkan tulisan yang rapi dan masuk akal secara tata bahasa, tetapi tidak lagi sesuai dengan situasi atau budaya yang melatarbelakangi pesan.
Perubahan itu sulit disadari karena tidak selalu ada bagian yang tampak janggal. Pengguna mungkin melihat jawaban yang meyakinkan, padahal konteks penting telah terlepas selama pemrosesan. Ketika informasi berpindah melalui beberapa model, kekeliruan yang mula-mula kecil berpeluang memengaruhi hasil akhir.
Risiko terlihat pada analisis keuangan
Telset.id menggambarkan dampaknya lewat analisis laporan tahunan perusahaan oleh sejumlah agen AI. Dalam contoh tersebut, agen pertama menyamakan laba bersih dengan laba operasi. Padahal, kedua istilah itu merujuk pada ukuran yang berbeda.
Laba operasi menggambarkan keuntungan dari kegiatan bisnis perusahaan. Laba bersih merupakan sisa setelah berbagai pengurang, termasuk pajak, depresiasi, pembayaran utang, serta biaya lain, diperhitungkan. Jika perbedaan itu luput sejak awal, agen berikutnya dapat meneruskan analisis berdasarkan pengertian yang keliru.
Kesalahan seperti ini tidak harus muncul sebagai angka yang jelas-jelas ganjil. Ia dapat tertanam dalam rangkaian analisis dan memengaruhi wawasan yang kemudian dipakai pembaca. Dalam konteks laporan keuangan, salah memahami istilah berarti berisiko salah membaca kondisi perusahaan dan mengambil keputusan berdasarkan kesimpulan yang tidak tepat.
Niat manusia lebih luas dari susunan kata
Makna percakapan juga dipengaruhi nada suara, emosi, serta keadaan saat kalimat disampaikan. Ungkapan yang sama dapat terasa sebagai perhatian bila disampaikan dengan lembut, tetapi terdengar seperti teguran jika nadanya keras. Teks saja tidak selalu memuat petunjuk tersebut.
Persoalan bertambah ketika pengguna berbicara kepada AI seperti berbicara kepada manusia. Model mengolah pola kata secara statistik, bukan merasakan emosi yang menyertai ucapan. Telset.id menyebut adanya paradoks pemampatan niat: ketika prompt dipersingkat untuk menghemat token, konteks yang menerangkan maksud pengguna juga dapat ikut hilang.
Model yang diarahkan memberi jawaban analitis tetap dapat salah membaca tujuan pertanyaan. Karena itu, jawaban yang terstruktur bukan jaminan bahwa maksud pengguna telah dipahami dengan benar. Ketepatan bergantung pula pada konteks yang tersedia dan cara informasi diteruskan.
Data terkurasi dan watermark sebagai upaya
Tidak ada satu cara yang langsung menghapus risiko semantic erosion. Salah satu pendekatan yang dibahas Telset.id ialah memperkaya data pelatihan dengan materi yang lebih terkurasi, seperti jurnal yang ditelaah sejawat, diskusi pakar, artikel mendalam, dan literatur. Materi semacam itu dinilai dapat membantu model mengenali konteks dan membangun penalaran yang lebih baik dibandingkan hanya mengandalkan data generik.
Data terkurasi membutuhkan biaya lebih besar. Namun, pengembang tidak harus mengganti seluruh bahan pelatihan; memasukkan porsi berarti dari materi berkualitas tinggi dapat menjadi bagian dari upaya meningkatkan pemahaman konteks dan keandalan model.
Pengembang juga dapat memberi watermark kriptografis atau statistik pada keluaran AI. Telset.id mencontohkan SynthID dari Google. Penanda itu dapat membantu model mengenali konten yang dihasilkan AI, sehingga keluaran tersebut tidak digunakan kembali begitu saja sebagai bahan pelatihan. Langkah ini ditujukan untuk mengurangi risiko model collapse, yakni penurunan kualitas ketika model terus dilatih menggunakan hasil produksinya sendiri.
Bagi pengguna, kelancaran bahasa AI tetap perlu dibedakan dari ketepatan makna. Untuk informasi yang sensitif terhadap istilah atau konteks, pemeriksaan manusia masih dibutuhkan, terutama sebelum hasil analisis dipakai sebagai dasar keputusan.